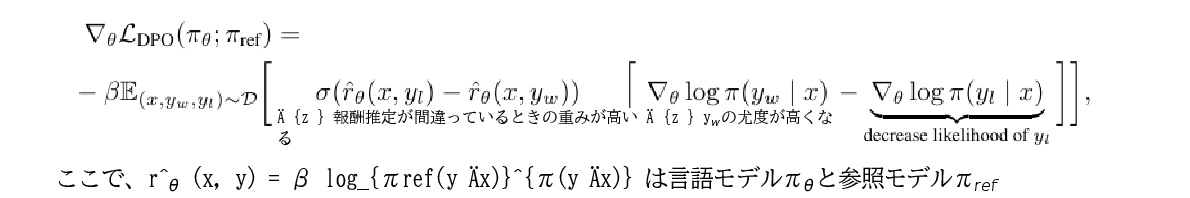論文やWeb文献をいい感じに翻訳いい感じに管理

最高精度の翻訳と読書体験、AIによって自動化された文献管理。論文・文献を読んで管理する、すべての工程を完璧にサポート

Direct Preference Optimization: Your Language Model is Secretly a Reward Model

4 Direct Preference Optimization

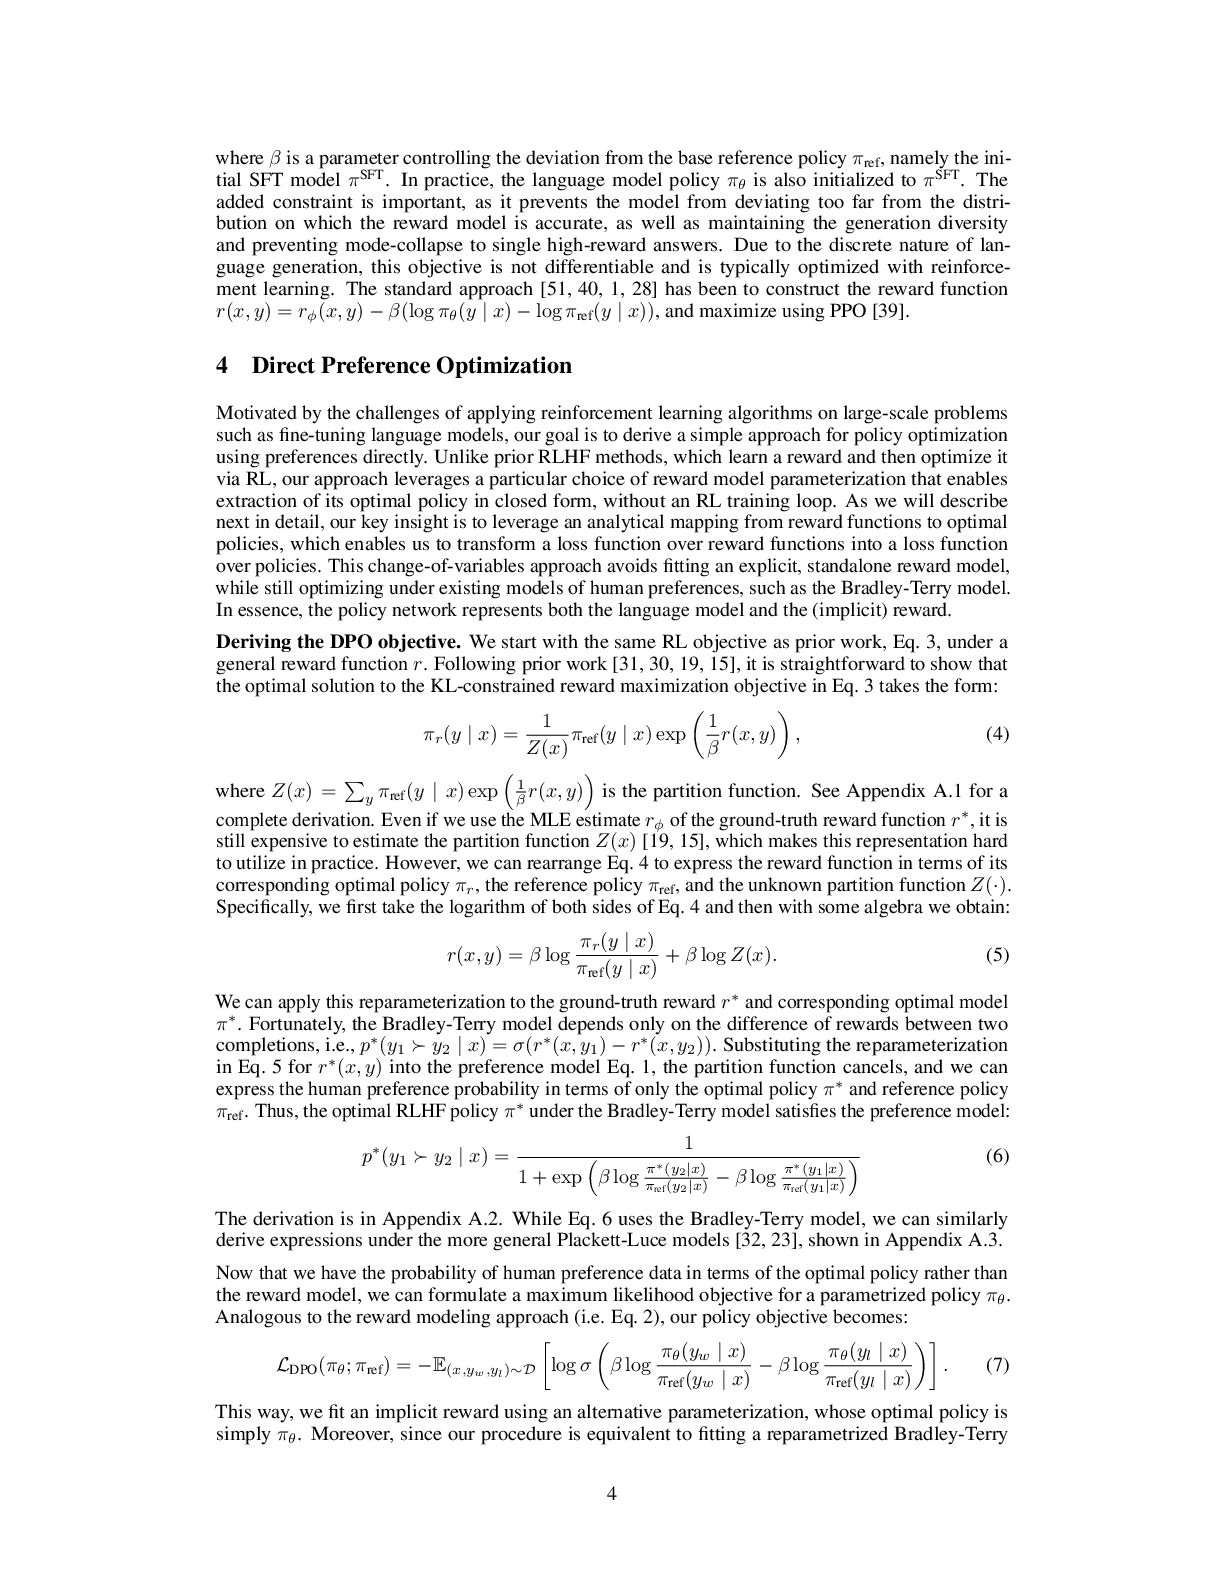
大規模言語モデルのファインチューニングのような大規模な問題に強化学習アルゴリズムを適用する際の課題を踏まえ、我々の目標は選好を直接用いる方策最適化の単純な手法を導出することである。報酬を学習してから強化学習によって最適化する従来のRLHF手法とは異なり、我々の手法では、報酬モデルの特定のパラメータ化を利用することで、強化学習の学習ループを介さずに最適方策を閉形式で導出できる。次に詳しく述べるように、我々の重要な着想は、報酬関数から最適方策への解析的な写像を利用し、報酬関数上の損失関数を方策上の損失関数へと変換することである。この変数変換によるアプローチでは、Bradley-Terryモデルなど、既存の人間の選好モデルに基づく最適化を維持したまま、明示的な独立した報酬モデルの適合を避けられる。本質的には、方策ネットワークが言語モデルと(暗黙的な)報酬の両方を表す。

DPO目的関数の導出

一般的な報酬関数 rr のもとで、先行研究と同じ強化学習目的関数である Eq. 3 から始める。先行研究 [31]、[30]、[19]、[15] に従うと、Eq. 3 の KL制約付き報酬最大化目的関数の最適解が次の形式をとることは容易に示せる。

πr(y∣x)=1Z(x)πref(y∣x)exp⁡(1βr(x,y)),(4)\pi_r(y\mid x)=\frac{1}{Z(x)}\pi_{\mathrm{ref}}(y\mid x)\exp\left(\frac{1}{\beta}r(x,y)\right), \tag{4}

ここで、Z(x)=∑yπref(y∣x)exp⁡(1βr(x,y))Z(x)=\sum_y\pi_{\mathrm{ref}}(y\mid x)\exp\left(\frac{1}{\beta}r(x,y)\right) は分配関数である。完全な導出については付録 A.1 を参照されたい。真の報酬関数 r∗r^* のMLE推定値 rϕr_\phi を用いる場合であっても、分配関数 Z(x)Z(x) の推定には依然として大きなコストがかかり [19]、[15]、この表現は実際に利用しにくい。しかし、Eq. 4 を変形すれば、報酬関数を、それに対応する最適方策 πr\pi_r、参照方策 πref\pi_{\mathrm{ref}}、および未知の分配関数 Z(⋅)Z(\cdot) によって表せる。具体的には、まず Eq. 4 の両辺の対数を取り、いくつかの代数的操作を行うと、次を得る。

r(x,y)=βlog⁡πr(y∣x)πref(y∣x)+βlog⁡Z(x).(5)r(x,y)=\beta\log\frac{\pi_r(y\mid x)}{\pi_{\mathrm{ref}}(y\mid x)}+\beta\log Z(x). \tag{5}

この再パラメータ化を、真の報酬 r∗r^* と対応する最適モデル π∗\pi^* に適用できる。幸いなことに、Bradley-Terryモデルは2つの完了文の報酬の差のみに依存する。すなわち、p∗(y1≻y2∣x)=σ(r∗(x,y1)−r∗(x,y2))p^*(y_1\succ y_2\mid x)=\sigma(r^*(x,y_1)-r^*(x,y_2)) である。r∗(x,y)r^*(x,y) に対する Eq. 5 の再パラメータ化を選好モデル Eq. 1 に代入すると、分配関数は相殺され、人間の選好確率を最適方策 π∗\pi^* と参照方策 πref\pi_{\mathrm{ref}} のみを用いて表せる。したがって、Bradley-Terryモデルのもとでの最適なRLHF方策 π∗\pi^* は、次の選好モデルを満たす。

p∗(y1≻y2∣x)=11+exp⁡(βlog⁡πref(y2∣x)π∗(y2∣x)−βlog⁡π∗(y1∣x)πref(y1∣x)).(6)p^*(y_1\succ y_2\mid x)=\frac{1}{1+\exp\left(\beta\log\frac{\pi_{\mathrm{ref}}(y_2\mid x)}{\pi^*(y_2\mid x)}-\beta\log\frac{\pi^*(y_1\mid x)}{\pi_{\mathrm{ref}}(y_1\mid x)}\right)}. \tag{6}

導出は付録 A.2 に示す。Eq. 6 ではBradley-Terryモデルを用いているが、付録 A.3 に示すように、より一般的なPlackett-Luceモデル [32]、[23] のもとでも同様に式を導出できる。報酬モデルではなく最適方策を用いて人間の選好データの確率を表せるようになったため、パラメータ化された方策 πθ\pi_\theta に対する最尤目的関数を定式化できる。報酬モデル化のアプローチ(すなわち Eq. 2)と同様に、方策の目的関数は次のようになる。

LDPO(πθ;πref)=−E(x,yw,yl)∼D[log⁡σ(βlog⁡πθ(yw∣x)πref(yw∣x)−βlog⁡πθ(yl∣x)πref(yl∣x))].(7)L_{\mathrm{DPO}}(\pi_\theta;\pi_{\mathrm{ref}})=-\mathbb{E}_{(x,y_w,y_l)\sim D}\left[\log\sigma\left(\beta\log\frac{\pi_\theta(y_w\mid x)}{\pi_{\mathrm{ref}}(y_w\mid x)}-\beta\log\frac{\pi_\theta(y_l\mid x)}{\pi_{\mathrm{ref}}(y_l\mid x)}\right)\right]. \tag{7}

この方法では、別のパラメータ化を用いて暗黙的な報酬を適合させ、その最適方策は単に πθ\pi_\theta となる。さらに、我々の手順は再パラメータ化されたBradley-Terryモデルの適合と等価であるため、選好データ分布に関する適切な仮定のもとでの一致性 [4] など、一定の理論的性質を備えている。DPOの理論的性質と他の研究との関係については、Section 5 でさらに議論する。

DPOの更新は何を行うのか?

DPOの仕組みを理解するには、損失関数 LDPOL_{\mathrm{DPO}} の勾配を分析するとよい。パラメータ θ\theta に関する勾配は、次のように表せる。

∇θLDPO(πθ;πref)=−βE(x,yw,yl)∼D[σ(r^θ(x,yl)−r^θ(x,yw))⋅(∇θlog⁡πθ(yw∣x)−∇θlog⁡πθ(yl∣x))],\begin{aligned} \nabla_\theta L_{\mathrm{DPO}}(\pi_\theta;\pi_{\mathrm{ref}}) ={}&-\beta\mathbb{E}_{(x,y_w,y_l)\sim D}\left[\sigma\left(\hat r_\theta(x,y_l)-\hat r_\theta(x,y_w)\right)\right.\\ &\left.\qquad\qquad\qquad\quad\cdot\left(\nabla_\theta\log\pi_\theta(y_w\mid x)-\nabla_\theta\log\pi_\theta(y_l\mid x)\right)\right], \end{aligned}

ここで、r^θ(x,y)=βlog⁡πθ(y∣x)πref(y∣x)\hat r_\theta(x,y)=\beta\log\frac{\pi_\theta(y\mid x)}{\pi_{\mathrm{ref}}(y\mid x)} は、言語モデル πθ\pi_\theta と参照モデル πref\pi_{\mathrm{ref}} によって暗黙的に定義される報酬である(詳細は Section 5)。直感的には、損失関数 LDPOL_{\mathrm{DPO}} の勾配は、選好される完了文 ywy_w の尤度を上げ、選好されない完了文 yly_l の尤度を下げる。重要なのは、例の重みが、暗黙的な報酬モデル r^θ\hat r_\theta が選好されない完了文をどれほど高く評価しているかに応じて定まり、β\beta によってスケーリングされる点である。つまり、KL制約の強さを考慮しつつ、暗黙的な報酬モデルが完了文の順序をどれほど誤っているかに応じて重み付けされる。我々の実験は、この重み付けの重要性を示唆している。重み係数を用いない素朴な手法では、言語モデルが退化する可能性がある(付録 表 3)。

DPOの概要

DPOの一般的なパイプラインは次のとおりである。1) 各プロンプト xx に対して πref(⋅∣x)\pi_{\mathrm{ref}}(\cdot\mid x) から完了文 y1,y2∼πref(⋅∣x)y_1,y_2\sim\pi_{\mathrm{ref}}(\cdot\mid x) をサンプリングし、人間の選好によってラベル付けして、オフラインの選好データセット D={(x(i),yw(i),yl(i))}i=1ND=\{(x^{(i)},y_w^{(i)},y_l^{(i)})\}_{i=1}^N を構築する。2) 与えられた πref\pi_{\mathrm{ref}} と DD、および所望の β\beta に対して、LDPOL_{\mathrm{DPO}} を最小化するよう言語モデル πθ\pi_\theta を最適化する。実際には、サンプルを生成して人間の選好を収集するよりも、公開されている選好データセットを再利用することが望ましい。選好データセットは πSFT\pi_{\mathrm{SFT}} を用いてサンプリングされているため、利用可能な場合は πref=πSFT\pi_{\mathrm{ref}}=\pi_{\mathrm{SFT}} と初期化する。しかし、πSFT\pi_{\mathrm{SFT}} が利用できない場合は、選好される完了文 (x,yw)(x,y_w) の尤度を最大化して πref\pi_{\mathrm{ref}} を初期化する。すなわち、

πref=arg⁡max⁡πEx,yw∼D[log⁡π(yw∣x)].\pi_{\mathrm{ref}}=\arg\max_\pi\mathbb{E}_{x,y_w\sim D}[\log\pi(y_w\mid x)].

この手順により、利用できない真の参照分布と、DPOで用いる πref\pi_{\mathrm{ref}} との間の分布シフトを軽減できる。実装とハイパーパラメータの詳細については、付録 B を参照されたい。
例示: Rafailov et al., NeurIPS 2023 (arXiv:2305.18290), CC BY 4.0。訳文は Re:Babel による機械翻訳で、手を加えていません。AI の回答は Re:Babel の AI 質問(GPT-6 Luna)の実際の出力です。

圧倒的な翻訳精度と読書体験

競合他社よりReadable読みやすい

他社 PDF 翻訳サービスの実際の出力

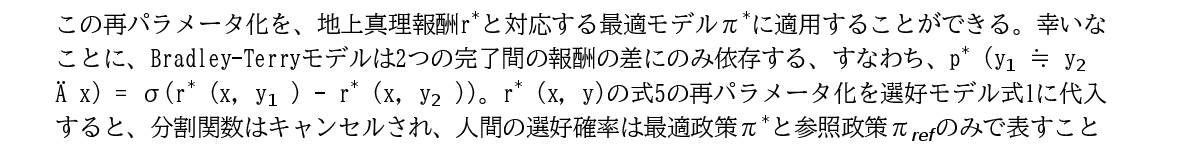
他社サービスの訳文。「地上真理報酬」「p*(y1 ≒ y2 Ä x)」など、訳語と記号が崩れている
  1. ① ground-truth が「地上真理」に
  2. ② ≻ が ≒、| が Ä に化ける
  3. ③ 「分配関数」が「分割関数」、cancel が「キャンセル」

Re:Babel

訳文

この再パラメータ化を、真の報酬 r∗r^* と対応する最適モデル π∗\pi^* に適用できる。幸いなことに、Bradley-Terryモデルは2つの完了文の報酬の差のみに依存する。すなわち、p∗(y1≻y2∣x)=σ(r∗(x,y1)−r∗(x,y2))p^*(y_1\succ y_2\mid x)=\sigma(r^*(x,y_1)-r^*(x,y_2)) である。r∗(x,y)r^*(x,y) に対する Eq. 5 の再パラメータ化を選好モデル Eq. 1 に代入すると、分配関数は相殺され、人間の選好確率を最適方策 π∗\pi^* と参照方策 πref\pi_{\mathrm{ref}} のみを用いて表せる。したがって、Bradley-Terryモデルのもとでの最適なRLHF方策 π∗\pi^* は、次の選好モデルを満たす。

リーダーで開く

他社 PDF 翻訳サービスの実際の出力

他社サービスの訳文。式の注釈が化けて重なり、LaTeX のソースがそのまま出力されている
  1. ① 式の注釈が化けて重なり、読めない
  2. ② LaTeX のソースがそのまま出る

Re:Babel

訳文

∇θLDPO(πθ;πref)=−βE(x,yw,yl)∼D[σ(r^θ(x,yl)−r^θ(x,yw))⋅(∇θlog⁡πθ(yw∣x)−∇θlog⁡πθ(yl∣x))],\begin{aligned} \nabla_\theta L_{\mathrm{DPO}}(\pi_\theta;\pi_{\mathrm{ref}}) ={}&-\beta\mathbb{E}_{(x,y_w,y_l)\sim D}\left[\sigma\left(\hat r_\theta(x,y_l)-\hat r_\theta(x,y_w)\right)\right.\\ &\left.\qquad\qquad\qquad\quad\cdot\left(\nabla_\theta\log\pi_\theta(y_w\mid x)-\nabla_\theta\log\pi_\theta(y_l\mid x)\right)\right], \end{aligned}

ここで、r^θ(x,y)=βlog⁡πθ(y∣x)πref(y∣x)\hat r_\theta(x,y)=\beta\log\frac{\pi_\theta(y\mid x)}{\pi_{\mathrm{ref}}(y\mid x)} は、言語モデル πθ\pi_\theta と参照モデル πref\pi_{\mathrm{ref}} によって暗黙的に定義される報酬である(詳細は Section 5)。

リーダーで開く

読書体験

PDF追従

訳文をスクロールすると、PDF の同じ段落に印がついてきます。図や表の位置もすぐ分かります。

ラインマーカー・メモ

原文にも訳文にも、4色のマーカーとメモ。書き出した Markdown にも残ります。

AIに質問

分からない箇所を選んで「聞く」。論文の本文と図表をもとに答え、根拠の段落へのリンクが付きます。

とにかく楽な文献管理

  • 自動でタグ、学会付け

    PDF や URL を入れるだけで、著者や掲載先の学会・論文誌、分野のタグまで自動で付きます。

  • タグ・学会で絞り込み

    タグやコレクション、掲載先で、積んだ論文をすぐに絞り込めます。

  • bibをそのままコピー

    BibTeX・RIS をワンクリックでコピー。コレクションごとに .bib で書き出せます。

プラン

Free
¥0 / 月
  • 文献追加 20 件 / 月
  • 100 クレジット / 月(PDF の OCR + 標準グレード翻訳で約 33 ページ)
  • 基本グレード・標準グレードの品質
  • 訳文の閲覧は作成から30日間
無料で始める
おすすめPlus
¥500 / 月
  • 文献追加 200 件 / 月
  • 500 クレジット / 月(PDF の OCR + 標準グレード翻訳で約 166 ページ)
  • ダウンロード・エクスポート(訳文・原文・対訳 Markdown、原本ファイル、BibTeX/RIS、印刷)
  • 訳文を期限なく閲覧
Plus を始める
Pro
¥3,000 / 月
  • 文献追加 2,000 件 / 月
  • 3,000 クレジット / 月(PDF の OCR + 標準グレード翻訳で約 1,000 ページ)
  • 高精度グレードの品質
  • ダウンロード・エクスポート(訳文・原文・対訳 Markdown、原本ファイル、BibTeX/RIS、印刷)
  • 訳文を期限なく閲覧
Pro を始める

価格は税込。クレジットは OCR と翻訳で、ページ数に応じて消費されます。